决策模型杀到GPT-6身后!只差3分,速度快40倍、成本仅1/15
- 智东西
- 2026-11-10 19:27:27
智东西编译 黄菲编辑 江宇
 (资料图)
智东西11月9日消息,昨日,AI模型评测机构Artificial Analysis更新AI决策模型评测榜单Artificial Analysis Decision Index v2(以下简称Decision Index v2),专业决策模型Drex Max v1.1、GLiDE v1.2均获得73分,并列第一,Mammoth 27B以72分紧随其后,三款模型得分仅相差1分。
在纳入通用语言模型的排行榜中,Anthropic模型Claude Haiku 5.5(Max)和OpenAI模型GPT-6 Luna(Max)分别获得77分和76分,包揽榜单前两名,前三名的专业决策模型仅落后得分最高的通用语言模型3至4分。
通用语言模型虽然在综合得分上领先,但其使用成本和任务耗时也明显更高。
其中,Claude Haiku 5.5(Max)在榜单所列模型中最高,每百万项任务达到6240美元(约合人民币4.19万元),约为榜单内并列第一的最佳专业决策模型Drex Max v1.1的61倍,单项任务耗时是其119倍;GPT-6 Luna(Max)每百万项任务的成本达到1530美元(约合人民币1.03万元),是Drex Max v1.1的15倍,单项任务耗时约为后者的40倍。
但专业决策模型的使用成本并非都很低,其模型之间也存在明显的差异。
每百万项任务中,成本最低的专业决策模型Celeris-1.1 Decision仅需14美元(约合人民币94元),而成本最高的Clef则需要859美元(约合人民币5772元),两者相差超过60倍。
不过,这种成本差异不仅与模型本身有关,也受到具体调用方式的影响。以GLiDE v1.2为例,该模型在处理每道题时,都需要重新输入整份文档并计算输入成本,无法在同一份文档的多道题之间复用输入内容。因此,其每百万项任务的成本达到780美元(约合人民币5242元),约为Drex Max v1.1的7.6倍。
一、三款专业决策模型得分仅差1分,头部竞争趋于激烈
在Decision Index v2的专业决策模型排名中,AI决策技术公司Nace AI的模型Drex Max v1.1和AI研究团队Fastino Labs的模型GLiDE v1.2均获得73分,并列第一;AI研究团队Baseten的模型Mammoth 27B获得72分,排名第二。
三款模型的得分仅相差1分,头部专业决策模型在综合评测中的表现已经十分接近。
若将通用语言模型纳入比较,Anthropic模型Claude Haiku 5.5(Max)以77分排名第一,OpenAI模型GPT-6 Luna(Max)获得76分,分别比专业决策模型榜首高出4分和3分。
▲Artificial Analysis Decision Index v2模型综合得分榜单,来源:Artificial Analysis
此次该榜单更新的一项重要变化,是Artificial Analysis调整了评分方式,将所测模型对答案的置信度纳入决策得分(Decision Score)的计算。
每道题的得分为0至100分,答对时得分高于50分,答错时低于50分。模型答对且对自己的判断有把握,会获得更高分数;如果模型对自己的答案很有把握却答错,受到的惩罚也越大。
这一评分机制也考虑了决策模型在实际应用中的工作方式。通常,模型只有在置信度达到一定阈值时,答案才会被直接采用;如果置信度不足,任务就会转交给人工或能力更强的模型处理。决策得分则综合计算不同置信度阈值下的预期收益。
具体到每道题,其得分公式为:50×(1+c−(p−c)²)
其中,p代表模型为所选答案分配的概率,c代表答案是否正确,答对时c=1,答错时c=0。
汇总整个测试集后,该公式等价于:50×(1+Accuracy−Brier Score)
其中,布里尔评分(Brier Score)用于衡量模型给出的答案概率与实际结果之间的差距,分数越低,说明模型的置信度校准越准确。
从专业决策模型榜单的布里尔评分来看,模型Elephant 9B、Clef-Omni、Drex Max v1.1和Drex 2.0并列第一,均为0.16;其余多数模型的布里尔评分集中在0.17-0.20左右;其中模型Clef、Mercury Decide置信度校准表现相对较弱,分别为0.23与0.26。
▲Decision Score将答案正确性与置信度校准纳入统一评分机制,来源:Artificial Analysis
在测试集方面,Decision Index v2共整合6项评测,包括AA-Paperclip、EvalSafe-O NET-AA、AA-Omniscience-Decision v1.1、HLE-MultiChoice v1.1、AA-Symmetry和When2Call,分别考察文档决策与信息提取、职场文档判断、知识掌握与避免错误信息、推理、答案一致性以及工具调用能力。
其中,新增的AA-Paperclip占总评分的30%,AA-Symmetry占15%。此外,Artificial Analysis将私有数据集在总评测中的占比从25%提高至45%;AA-Omniscience-Decision和HLE-MultiChoice的权重均从25%降至15%,When2Call的权重则从25%降至10%。由于WildGuardTest测试集的饱和度较高,该项目被移出新版榜单。
AA-Paperclip包含1500份文档,涵盖简历、收据、发票,以及AI和机器学习研究论文。每份文档包含5道决策题和10道事实提取题,模型必须全部答对才能通过测试。
在这一测试中,Claude Haiku 5.5(Max)的文档整体通过率为92%,GPT-6 Luna(Max)为86%,均高于表现最好的专业决策模型Drex Max v1.1(63%)。
具体来看,Drex Max v1.1的失分更多集中在决策环节。虽然其单项答案正确率达到97%,与Claude Haiku 5.5(Max)的99%接近,但Drex Max v1.1仅在71%的文档中答对了全部5道决策题,在88%的文档中正确提取了全部10项事实,从而拉低了其整体文档通过率。
▲不同AI模型在AA-Paperclip真实文档测试中的通过率对比,来源:Artificial Analysis
另一项测试AA-Symmetry则考察模型面对不同措辞的等价问题时,能否保持判断一致。
该测试包含120道基础问题,共设置440种不同表述形式。Artificial Analysis通过调整选项顺序、交换选项标签,以及将是非题改写为否定问法等方式,检验所测模型是否会因为问题表达方式发生变化而改变答案。
在这一测试中,专业决策模型Mammoth 27B(96分)、Elephant 9B(93分)领先其余模型。具体来看,模型Mammoth 27B在99%的问题中能够保持不同表述下的答案一致,而决策模型Clef仅为67%。
Artificial Analysis提到,部分模型在这一测试中的优势与较高的弃答率有关。面对不确定的问题,这些模型更倾向于承认自己不知道,并在不同问题表述下保持这一判断,从而获得更高的一致性得分。
▲不同AI模型在AA-Symmetry测试中的答案一致性表现,来源:Artificial Analysis
二、通用语言模型得分更高,成本和任务耗时也同步增加
如果只看Decision Index综合得分,通用语言模型仍然占据优势。
在通用语言模型中,Anthropic模型Claude Haiku 5.5(Max)获得77分,OpenAI模型GPT-6 Luna(Max)获得76分,分别比与此次评测中表现最好的专业决策模型Drex Max v1.1、GLiDE v1.2的73分高出4分和3分。
但这种性能优势却伴随着更高的使用成本和更长的任务处理时间。
按测评时通用语言模型以输入和输出Token计费,GPT-6 Luna(Max)完成每百万项任务的成本达到1530美元(约合人民币1.03万元),是最佳专业决策模型之一的Drex Max v1.1(102美元(约合人民币681元))的15倍;完成单项任务需要11.34秒,也约为Drex Max v1.1(275毫秒)的40倍。
Claude Haiku 5.5(Max)的任务成本更高,完成每百万项任务需要6240美元(约合人民币4.19万元),单项任务耗时达到32.65秒,是最佳专业决策模型之一的Drex Max v1.1的61倍,单项任务耗时是后者的119倍。
相比之下,专业决策模型Celeris-1.1 Decision的单项任务耗时仅为56毫秒,是此次榜单中速度最快的模型。
此外,专业决策模型Mammoth 27B的综合得分与通用语言模型GPT-6 Luna(Max)仅相差4分的同时,任务处理速度却快了118倍。
▲不同AI模型完成单项决策任务的耗时对比,来源:Artificial Analysis
整体来看,在相差不大的综合得分上,专业决策模型能够以更低的成本和更短的响应时间完成特定任务。
三、专业决策模型成本相差超60倍,调用方式影响实际支出
在每百万项任务的成本方面,专业决策模型之间的差距超过60倍。
按照评测时专业决策模型以输入Token计费,其决策模型在完成每百万项的任务中,Celeris-1.1 Decision的成本最低,为14美元(约合人民币93元);Decider v1.2为68美元(约合人民币454元);Drex Max v1.1为102美元(约合人民币681元)。
这三款模型均处于Decision Index得分与任务成本的帕累托前沿,即在当前成本水平下,难以找到得分更高的模型,或在相近得分下找到成本更低的模型。
相比之下,专业决策模型Clef的每百万项任务成本达到859美元(约合人民币5736元),是专业决策模型Celeris-1.1 Decision的61倍以上。
▲不同AI模型每百万项任务的成本及性能对比,来源:Artificial Analysis
不过,决策模型的实际使用成本并不只取决于Token单价,还与其处理任务的方式有关。
Artificial Analysis提到,大多数专业决策模型,包括Drex Max v1.1和Decider v1.2,在处理同一份文档中的多道题时,只会对文档输入内容计费一次。而GLiDE v1.2和Decider Flash v1.2则会针对每道题分别调用模型,每次调用都重新计算整份文档的输入成本。
以AA-Paperclip测试为例,专业决策模型GLiDE v1.2处理每项任务平均需要约6.3万个输入Token,而专业决策模型Drex Max v1.1只需要约9000个。
由于重复计算文档输入,最终任务成本明显更高。因此,专业决策模型GLiDE v1.2每百万项任务的成本达到780美元(约合人民币5208元),接近专业决策模型Drex Max v1.1的8倍,但前者的Token标价仅比后者高出33%。
专业决策模型Decider Flash v1.2也存在类似情况,其每百万项任务成本为196美元(约合人民币1309元),接近专业决策模型Decider v1.2的3倍,但其Token单价只有后者的一半。
结语:小模型比拼转向成本与执行效率
从此AI决策模型的测评榜单可以看到,头部专业决策模型的得分已经十分接近,但部分专业决策模型模型在特定任务中能够以远低于通用语言模型的成本完成工作。
尽管通用语言模型仍然在综合得分上领先,但在成本和响应速度方面,专业决策模型已经展现出明显优势。
来源:Artificial Analysis
申万宏源赵伟:2027年建议重点跟踪扩内需政策“内涵”变化
- 几个月前,成都蓉城主帅团队曾集体深情高歌一曲:“我们是冠军” 每日报道
- 民法典继承编解释(二)(征求意见稿)向社会征求意见 视焦点讯
- 台积电10月营收同比增近六成_当前热点
- 功夫少年,以拳会友!
- 恒生指数高开0.70% 恒生科技指数涨0.78%
- 记者:埃及助教巴西姆-阿里带队训练被叫停 速读
- 今日观点!36岁191天!乔治成为绿军队史单场0罚球25+的最年长球员
- 深圳高端腕表(理查德米勒 / 宝玑)变现怕遇到 “隐形扣费”? 认准正规实体连锁坐镇,资深鉴定师当面防掉包,资金安全当场秒结_最新快讯
- 一觉醒来,女子吓蒙:右眼出现大片黑影,一查视力只剩0.04!本人:一天要刷五六个小时短剧,以为休息一晚就好;医生:伤害覆盖每个年龄段-焦点快看








生意社PA6611月10日均差为25.00元/吨 由正向扩大转为缩小
据生意社监测,PA6611月10日均差为25 00元 吨(均差=M10-M20=19150 00-





远大医药(00512.HK)用于预防性治疗偏头痛的中药创新药 GPN01020 在中国开展的 II 期临床研究完成首例患者入组 动态
远大医药(00512 HK)公布,近日,集团用于预防性治疗偏头痛的中药创新药




【新股IPO】芯德半导体(07672)首挂收报11.4港元 较招股价高28.38% 聚看点
金吾财讯|芯德半导体(07672)首挂收报11 4港元,较招股价高28 38%,全






理文化工(00746.HK)大涨超10%,截至发稿,涨10.57%,报4.865港元,成交额319.59万港元
理文化工(00746 HK)大涨超10%,截至发稿,涨10 57%,报4 865港元,成交



当前资讯!机器人产业指数连涨2日,中证机器人指数PE处于近1年20%分位,机器人ETF国泰(159551)近30日获资金净流入
11月10日,A股三大指数集体飘红,创业板指涨1 81%领涨两市,上证指数涨




相关推荐
以下哪种动物的瞳孔是长方形的鸡和羊?蚂蚁庄园小课堂的问题答案来了
闽南网 2020/07/14
微信拍一拍搞笑词语大全,这个后缀的添加方法是什么?
中华网娱乐 2020/07/10
《人民的名义》收视率最高?原因是什么?
东方资讯 2020/07/07
《向往的生活》观看免费第四季,快乐家族版纳来“访亲”
中华网娱乐 2020/07/06
《局中人》全集观看在线播放, 兄弟二人嫌隙频生
海峡网 2020/07/02
《隐秘的角落》成为近期热度最高的国产网剧 豆瓣评分9分
上观新闻 2020/06/23
《隐秘的角落》全集免费高清在线观看,两大影帝以及多位实力派演员同框
闽南网 2020/06/22
《乘风破浪的姐姐》打破常规 受欢迎的背后更应该引发深思
上观新闻 2020/06/22
当晚会变成直播带货,各大卫视都出了哪些奇招?
中国新闻网 2020/06/18
泽塔奥特曼的最新消息:一起来看下泽塔奥特曼四个特殊的地方
次元岛 2020/06/17热门资讯 日 周 总
脑瘫的症状表现有哪些?脑瘫可以治愈成正常人吗?
人气网 2022/12/06
孤独症有什么表现?孤独症儿童可以治愈吗?
人气网 2022/12/06
如何缓解感冒症状?分享感冒时的注意事项和缓解方法
三思经验 2022/05/12
哪种食物补充维生素b?不妨来了解一下
今日头条 2020/07/16
鱼蒙眼如何治疗?想了解的可以进来看下
爱宠网 2020/07/07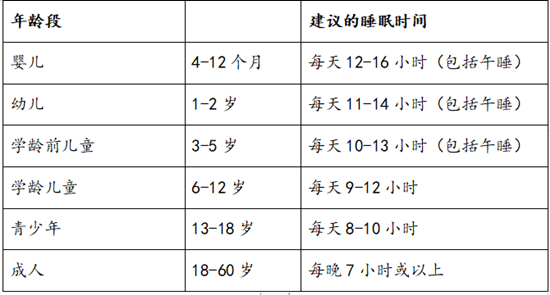
人需要多少睡眠?如何改善睡眠习惯?
人民网-科普中国 2020/06/09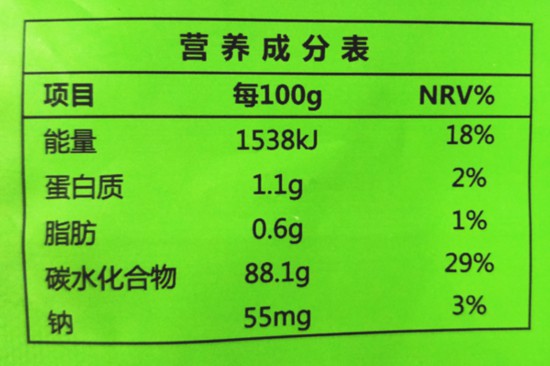
营养成分表你能看懂吗?来听听专家解析吧
新华网 2020/05/29
为什么运动后免疫力会短暂降低?如何运动才健康?
人民网-科普中国 2020/04/02
疫情期间,老年人居家如何合理用药?
光明网 2020/03/23
有人在身边咳嗽,我会感染新冠病毒吗?
人民网-人民健康网 2020/03/18
消息称饿了么智能柜开始向骑手收费:价格在0.3-0.6元不等
TechWeb 2022/05/06
中国联通用户凌晨被多扣95元叠加包?官方回应:已恢复正常
快科技 2022/05/06
再次被查!喜茶就饮品检出微生物污染道歉
光明网 2020/07/14
色情弹窗广告无疑会让人感到尴尬,为什么偏爱小说网?
中国新闻网 2020/07/13
“史上最严”的空调新国标来了!商家大力推新淘汰老库存
中国新闻网 2020/07/08
骚扰电话屡禁不绝 亟须重拳治理
人民网-人民日报海外版 2020/06/30
莫被恶意营销“牵着走” 网络恶意营销乱象亟待整治
人民网-人民日报海外版 2020/06/24
深圳市消委会:部分拖鞋样品邻苯二甲酸酯类含量超标上百倍 涉及回力、快鹿、集美
中国新闻网 2020/06/24
人吃河豚为什么会中毒?河豚毒素为什么这般厉害?
南方网 2020/06/16
直播行业互挖墙脚成常态 天价违约非个案
湖北日报 2020/06/16
定州:精准解决残疾人急难愁盼问题
河北经济日报 2026/01/22
“小米之乡”的“新”力量
河北经济日报 2026/01/22
今年的毕业季注定不同以往 希望“后浪”们开启人生新阶段的大门
人民网-文化频道 2020/06/30
“国货当自强”逐渐渗入国人的日常消费 国潮之风从何而起?
中国新闻网 2020/06/24
在卖画、卖房、质押资产后,华谊兄弟的命运会有所转变吗?
中国新闻网 2020/06/12
听见文学经典 传递人文之声
人民网-人民日报海外版 2020/06/12
天猫618有多火?全国最出名的美食街组团赶来参加!
中国经济网 2020/06/11
新职业在线学习平台启动2.0版本开发迭代工作 引领产业发展方向
人民网-财经频道 2020/06/10
《花繁叶茂》开播后口碑收视一路走高 意外俘获年轻的B站观众
上观新闻 2020/06/10